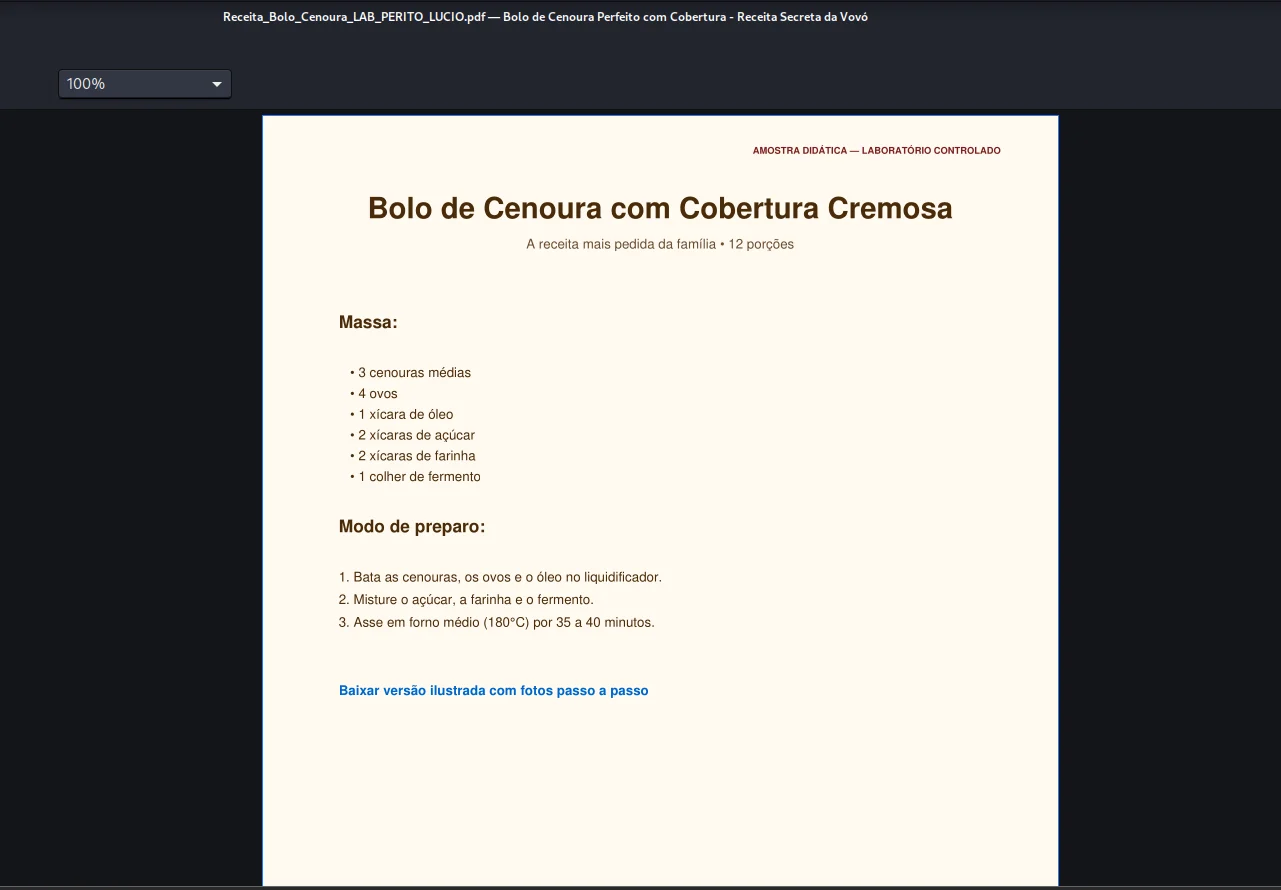
Baixe a amostra do laboratório
Use o arquivo somente no contexto educacional deste roteiro. O fluxo correto começa preservando o original, antes de abrir em um leitor de PDF.
2ce94e9bf166c5c9a7fc94c7c28ccb95ee6f7f6a4036469a11387d5fe443c7a4
Antes de abrir, eu quis saber se estava olhando para o arquivo certo
Quando um PDF chega por e-mail, WhatsApp ou download, a curiosidade normalmente fala primeiro: abrir o arquivo e ver o que tem dentro.
Mas, em uma análise, eu prefiro começar de outro lugar.
Antes de tentar entender o conteúdo, preciso registrar exatamente qual arquivo está sendo analisado. Afinal, um PDF pode ser copiado, reenviado, alterado, reexportado ou até substituído sem que isso fique evidente apenas olhando o nome.
É aqui que entra a hash SHA-256.
Ela funciona como uma impressão digital do arquivo. Não diz se o PDF é seguro, malicioso ou confiável. O que ela faz é permitir afirmar, com precisão, que o documento analisado agora é o mesmo documento que estava comigo no início.
No Kali, usei o comando abaixo:
cd ~/laboratorio/pdf-analise

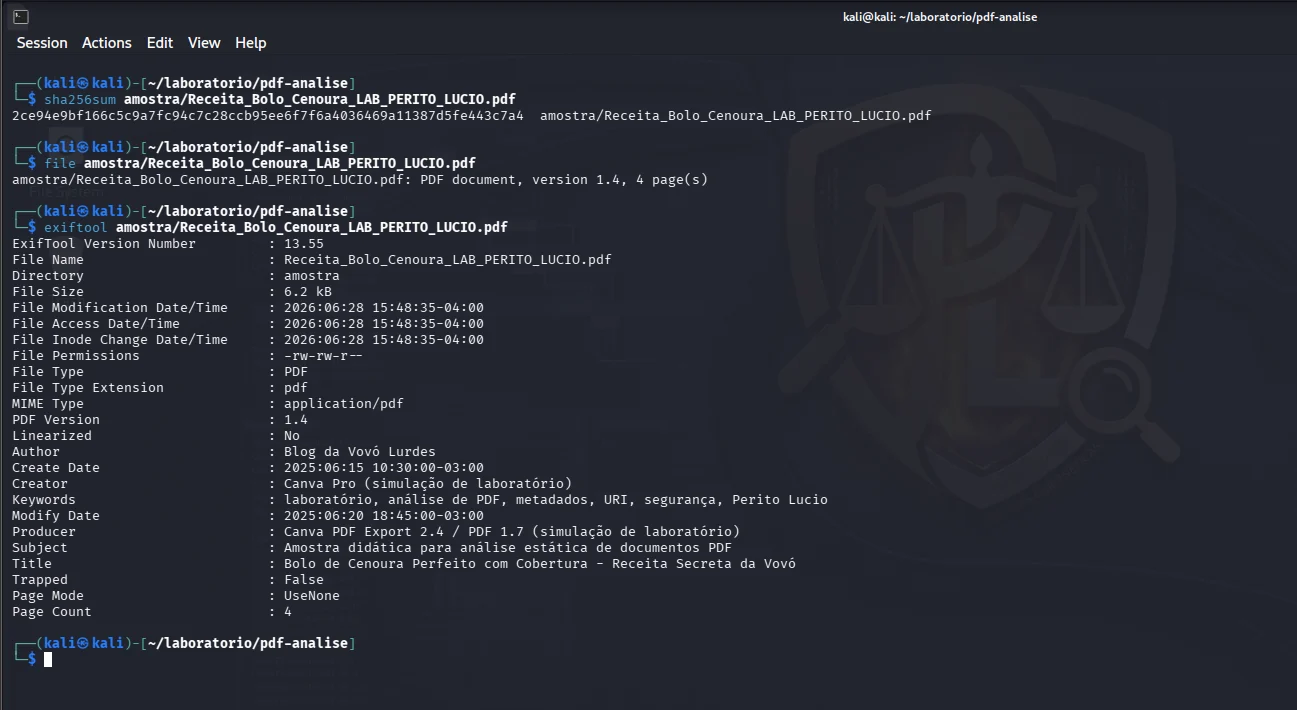
    sha256sum amostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdf
Além de mostrar a hash no terminal, o resultado foi salvo em um arquivo de evidência. É uma prática simples, mas importante: desde o começo, eu quero conseguir voltar e confirmar o que foi analisado.
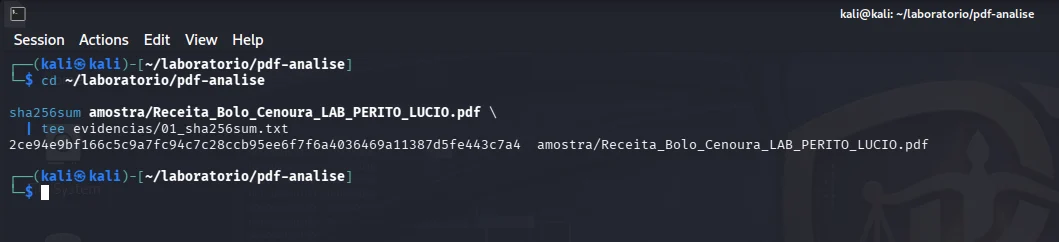
2ce94e9bf166c5c9a7fc94c7c28ccb95ee6f7f6a4036469a11387d5fe443c7a4Esse detalhe parece pequeno, mas faz diferença. Se alguém baixar a mesma amostra disponibilizada neste artigo e obtiver exatamente essa sequência, estará trabalhando com o mesmo arquivo.
Agora, uma observação importante: mudar apenas o nome do PDF não altera sua hash. Copiar o arquivo também não. Mas abrir em um editor, salvar novamente, adicionar um comentário, mexer em metadados ou alterar qualquer elemento interno já é suficiente para gerar uma identidade diferente.
Por isso, antes de qualquer investigação mais profunda, eu sempre preservo o original.
O arquivo se chama PDF. Mas ele é mesmo um PDF?
O nome do arquivo ajuda, mas não serve como prova.
Qualquer pessoa pode pegar um arquivo qualquer, trocar a extensão para .pdf e enviar como se fosse um documento comum. Em uma análise real, eu não gosto de confiar apenas no ícone, no nome ou no que aparece no e-mail.
Então, antes de seguir para metadados e links, confirmei o tipo real do arquivo pelo seu conteúdo interno.
No Kali, usei:
file amostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdfamostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdf: PDF document, version 1.4, 4 page(s)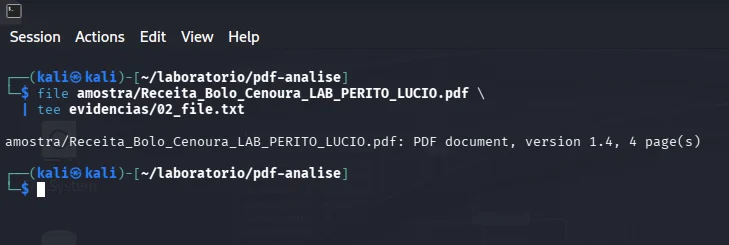
file confirma que o conteúdo do arquivo corresponde a um documento PDF de quatro páginas.Esse resultado não diz que o documento é seguro. Ele apenas confirma uma coisa importante: a extensão .pdf corresponde, de fato, ao formato identificado no arquivo.
Em outras palavras: não encontrei, neste ponto, um executável ou outro formato apenas disfarçado de PDF.
É uma verificação básica, mas vale a pena. Em incidentes reais, pequenos detalhes como esse ajudam a separar um arquivo que merece investigação mais profunda de uma tentativa mais evidente de enganar quem recebeu o documento.
Com a identidade registrada pela hash e o formato confirmado, eu podia começar a olhar para algo que costuma contar histórias interessantes: os metadados.
O que os metadados contam sobre esse PDF?
Depois de confirmar que eu estava, de fato, diante de um PDF, fui olhar para algo que normalmente passa despercebido: os metadados.
Todo documento costuma carregar informações internas sobre sua criação. Autor, programa utilizado, ferramenta que exportou o arquivo, data de criação, última modificação e outros detalhes podem ajudar a montar o contexto.
Isso não é uma prova isolada de que um arquivo é confiável ou suspeito. Metadados podem ser alterados, reaproveitados ou simplesmente não refletir a realidade. Mas, quando comparados com o conteúdo do documento e com a forma como ele chegou até você, eles podem levantar boas perguntas.
Neste caso, eu comecei usando o exiftool.
exiftool amostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdf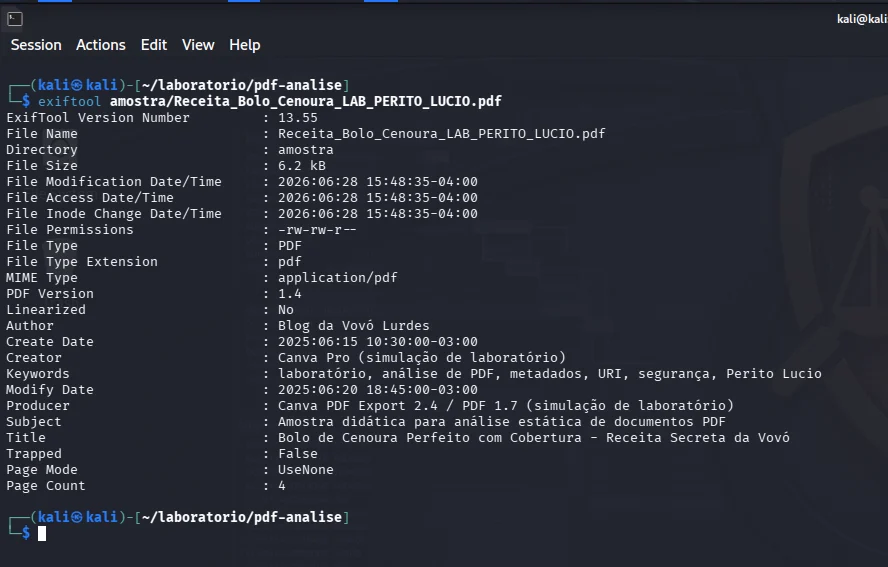
Na amostra, aparecem informações como “Blog da Vovó Lurdes” no campo de autor e referências a uma exportação simulada pelo Canva. Sozinhas, essas informações não significam muita coisa. Mas imagine receber uma cobrança bancária cujo campo Creator aponta para uma ferramenta de design, ou um documento corporativo criado por um programa que não faz parte da rotina daquela empresa.
É nesse tipo de comparação que os metadados começam a fazer sentido.
Também consultei o pdfinfo, que traz uma visão complementar do arquivo: quantidade de páginas, versão do PDF, criptografia, tamanho e propriedades internas.
pdfinfo amostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdf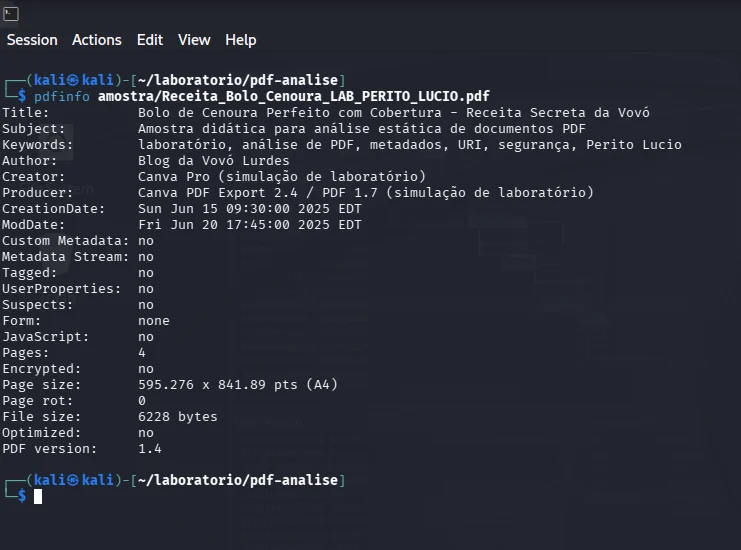
pdfinfo complementa a análise com informações próprias do formato PDF, incluindo páginas, versão, criptografia e campos de documento.Aqui, o arquivo se apresenta como um PDF 1.4 com quatro páginas e sem criptografia. Nada disso, por si só, indica um problema. Mas a análise ainda está só começando.
Até agora, eu confirmei a identidade do arquivo, validei que ele realmente é um PDF e observei o que ele declara sobre a própria origem.
A próxima pergunta é mais importante: o que existe dentro da estrutura desse documento além do texto que aparece na tela?
O que existe dentro do PDF além do que aparece na tela?
Até aqui, eu confirmei que o arquivo realmente é um PDF e observei os metadados que ele declara sobre a própria origem.
Mas um PDF não é só texto e imagem. Internamente, ele pode carregar ações automáticas, JavaScript, arquivos anexados, formulários e outros elementos que não ficam evidentes para quem apenas abre o documento.
Para uma primeira leitura estrutural, usei o pdfid.
pdfid amostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdf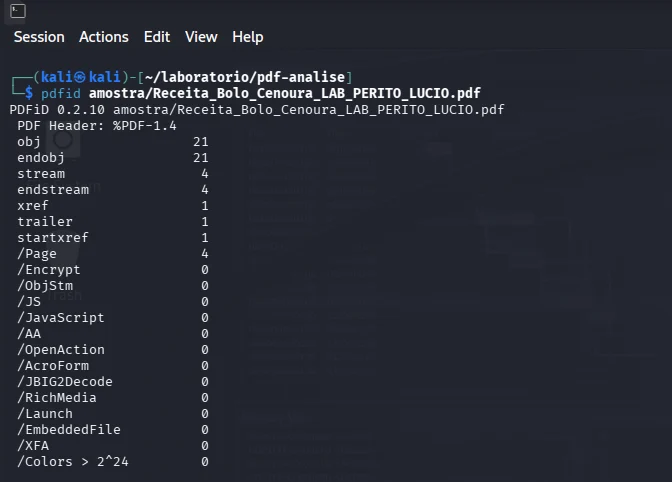
pdfid.O resultado mostrou um PDF com quatro páginas, 21 objetos e quatro streams internos. Até aqui, isso é compatível com um documento comum.
O ponto mais relevante está nos campos que permaneceram zerados:
/JS · /JavaScriptNenhum código JavaScript identificado.
/OpenActionNenhuma ação automática configurada para a abertura do PDF.
/LaunchNenhuma indicação de tentativa de iniciar uma ação externa.
/EmbeddedFileNenhum arquivo anexado dentro do documento.
/AcroForm · /XFANenhum formulário interativo identificado.
Esse tipo de resultado não permite afirmar que um PDF é seguro. Ele apenas mostra que, nesta amostra, não apareceram alguns dos indicadores que eu esperaria investigar com mais atenção em um documento suspeito.
Leitura correta: a saída padrão do pdfid não mostra links incorporados como /URI. Isso não significa que o PDF não tenha URLs. Significa apenas que, para enxergar esses links, eu preciso sair da triagem inicial e analisar os objetos internos do arquivo.
É exatamente o que vou fazer agora.
Os links que o PDF não mostra com clareza
Depois da triagem inicial, eu quis descobrir se existiam links incorporados no documento e para onde eles apontavam.
O texto que aparece na tela não é garantia do destino real de um clique. Por isso, em vez de abrir o PDF e sair clicando, fui direto à estrutura interna do arquivo.
pdf-parser --search /URI amostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdf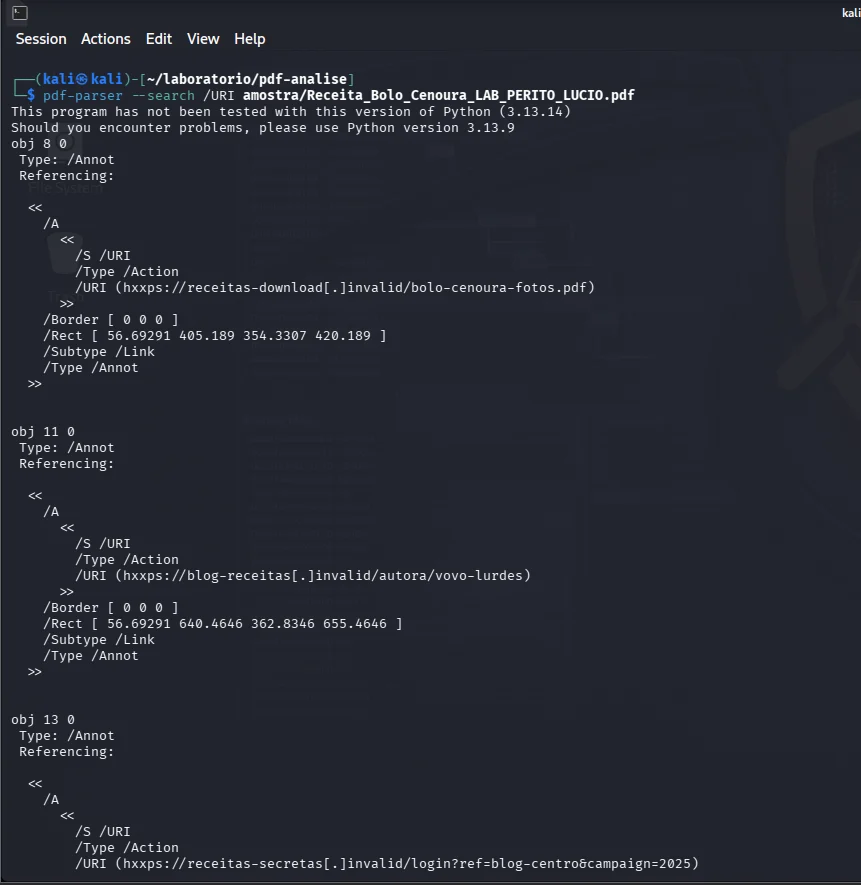
/URI no interior da amostra.A análise encontrou seis objetos de link dentro do PDF. Todos aparecem como anotações (/Annot) com uma ação do tipo /URI.
Entre os destinos encontrados estavam URLs relacionadas a download de receitas, acesso a portal, compartilhamento por e-mail e uma referência a bolo.exe.
Em um arquivo real, esse último detalhe chamaria atenção imediatamente. Mas aqui vale separar uma coisa da outra: o texto file=bolo.exe aparece apenas como parte de uma URL incorporada. Isso não significa que o PDF executa um arquivo.
A própria análise estrutural anterior já mostrou que não existem /Launch, /OpenAction ou JavaScript no documento. Ou seja: nesta amostra, o PDF contém links, mas não há indicação de execução automática ao ser aberto.
O risco, em um cenário real, estaria na interação da pessoa com um destino externo. Por isso, antes de clicar em qualquer link de um documento inesperado, eu verificaria se o domínio faz sentido para quem supostamente enviou o arquivo.
Nem tudo que existe no PDF aparece de forma evidente
Além dos links clicáveis, também quis verificar se havia URLs ou textos relevantes dentro do conteúdo do PDF.
pdftotext -layout amostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdf - | grep -nE 'hxxps|https?://'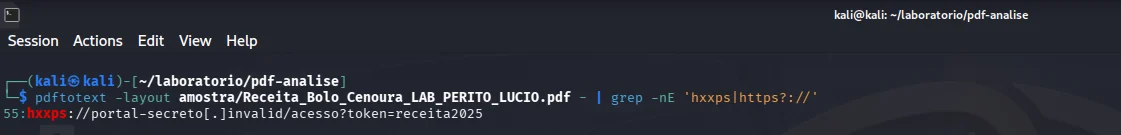
O comando encontrou uma URL na linha 55:
hxxps://portal-secreto[.]invalid/acesso?token=receita2025Esse endereço não apareceu na análise anterior como um link clicável porque ele não está dentro de um objeto /URI. Ele existe como texto no conteúdo do PDF.
Na amostra, esse texto foi inserido de forma visualmente discreta. Mas o pdftotext conseguiu extraí-lo normalmente.
É um bom lembrete: aquilo que não está evidente para quem lê o documento ainda pode fazer parte do arquivo. Em uma investigação real, eu compararia esse tipo de conteúdo com o contexto do material recebido e verificaria se há domínios, termos ou referências que não deveriam estar ali.
O PDF está bem formado. Isso não quer dizer que ele é seguro.
Por fim, eu quis verificar se o arquivo apresentava algum problema estrutural evidente.
qpdf --check amostra/Receita_Bolo_Cenoura_LAB_PERITO_LUCIO.pdf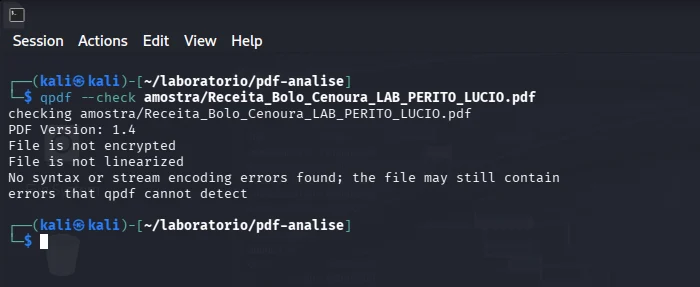
qpdf.O resultado confirmou que o arquivo é um PDF 1.4, não está criptografado e não apresentou erros de sintaxe ou de decodificação dos streams internos.
Isso é útil porque mostra que o documento está estruturalmente consistente. Em outras palavras: não encontrei um PDF corrompido, quebrado ou com erros básicos de formatação.
Mas existe um ponto importante aqui.
Um PDF pode estar perfeitamente bem formado e ainda assim conter links suspeitos, conteúdo enganoso ou elementos que merecem investigação. Integridade estrutural não é a mesma coisa que segurança.
O qpdf ajuda a responder: “o arquivo está tecnicamente íntegro?”. Ele não responde, sozinho: “esse arquivo é confiável?”.
O que encontrei neste PDF
Ao final da análise, a amostra apresentou o seguinte cenário:
Resumo da triagem
- O arquivo analisado foi identificado pela hash SHA-256.
- A extensão corresponde realmente a um documento PDF.
- Os metadados indicam uma origem declarada e uma ferramenta de criação simulada.
- Não foram encontrados JavaScript, execução automática, anexos incorporados ou ações de abertura.
- Foram identificados seis links internos.
- Um dos links não possui indicação visual clara dentro do documento.
- Uma URL adicional foi encontrada como texto discreto no conteúdo do PDF.
- O arquivo não apresentou erros estruturais evidentes.
A conclusão mais importante não é que “todo PDF é perigoso”.
Também não é que um comando isolado consegue dizer se um documento é seguro.
O que essa análise mostra é que, antes de abrir, clicar ou confiar em um arquivo recebido, vale a pena observar o que ele realmente contém.
Um PDF pode parecer apenas uma receita, uma cobrança, um currículo ou um comunicado. Mas, por trás da página que aparece na tela, podem existir links, objetos internos, metadados e informações que ajudam a contar uma história diferente.
Quando o contexto não faz sentido, quando o domínio não combina com quem enviou o arquivo ou quando algo parece escondido demais, minha recomendação é simples: não clique por impulso.
Preserve o arquivo, analise com calma e procure entender o que está ali antes de interagir.
Afinal, esse PDF é malicioso?
Depois de olhar para hash, tipo de arquivo, metadados, estrutura interna, links e conteúdo textual, chega a pergunta mais importante: esse PDF é malicioso?
Nesta amostra, não.
O arquivo foi criado para o laboratório e é seguro para análise. Ele contém elementos que merecem atenção em um cenário real, mas não contém mecanismos de execução automática ou domínios funcionais.
A amostra foi criada para o laboratório e contém elementos que, em um arquivo real, mereceriam atenção: links incorporados, uma área clicável sem indicação visual clara e uma URL discreta no conteúdo do documento.
Mas os indicadores precisam ser interpretados com contexto.
Nesta análise, não encontrei JavaScript, ações automáticas na abertura, comandos externos, arquivos incorporados ou qualquer mecanismo que execute algo sozinho. Os links encontrados também utilizam hxxps e o domínio .invalid, justamente para que não apontem para destinos reais.
Até a referência a bolo.exe, que poderia causar preocupação em uma investigação real, aparece apenas como parte de uma URL inativa. Não existe executável dentro do PDF e não há tentativa de download automático.
Esse é um ponto importante: encontrar algo estranho não significa, por si só, encontrar algo malicioso.
Em uma situação real, eu não classificaria um PDF apenas porque ele contém links, metadados incomuns ou texto pouco visível. Eu avaliaria o contexto: quem enviou, por qual canal, se o domínio combina com a empresa, se o assunto era esperado e se os demais indicadores reforçam ou não uma suspeita.
A análise técnica ajuda a reduzir incertezas. Mas a conclusão vem da correlação entre o arquivo, o comportamento esperado e o contexto em que ele apareceu.
O que eu faria se esse PDF tivesse chegado por e-mail?
Se esse arquivo tivesse chegado de forma inesperada, eu não trataria o PDF como malicioso sem evidências. Mas também não clicaria nos links apenas porque o documento parece inofensivo.
Eu começaria confirmando se o envio faz sentido.
Se o PDF supostamente veio de um banco, fornecedor, cliente ou colega, eu validaria por outro canal: uma ligação, uma mensagem em um contato já conhecido ou um novo e-mail enviado para o endereço oficial da empresa. Não responderia diretamente à mesma mensagem suspeita.
Também evitaria clicar em qualquer link dentro do documento antes de confirmar o destino real. No caso desta amostra, os links estavam em objetos internos do PDF e alguns não eram tão evidentes para quem apenas estivesse lendo a página.
Outro cuidado importante é não reenviar o arquivo para colegas sem contexto. Um PDF suspeito pode acabar circulando internamente e ganhar aparência de legitimidade apenas porque foi encaminhado por alguém conhecido.
Quando o arquivo contém informação sensível, eu também evitaria enviá-lo para serviços públicos de análise. Antes de subir qualquer documento para uma plataforma externa, é preciso avaliar se ele pode conter dados pessoais, contratos, informações corporativas ou conteúdo confidencial.
Um arquivo inesperado não precisa ser considerado malicioso para merecer cautela.
Antes de clicar, entenda o arquivo
A análise desta amostra não encontrou JavaScript, execução automática, anexos incorporados ou domínios funcionais. Ainda assim, o PDF continha links internos, uma área clicável sem indicação visual clara e uma URL discreta no conteúdo do documento.
Isso não torna o arquivo malicioso.
Mas mostra por que eu não gosto de confiar apenas no que aparece na tela.
Um PDF pode parecer uma receita, uma cobrança, um currículo ou um comunicado simples. Por trás da página visível, existem metadados, objetos internos, links e outros elementos que ajudam a entender melhor o que aquele arquivo realmente faz — ou tenta fazer.
Na prática, não existe um comando mágico capaz de responder sozinho se um documento é seguro. O que existe é método: preservar o arquivo, observar sua estrutura, verificar os links, comparar as informações com o contexto e evitar decisões por impulso.
No caso desta amostra, a conclusão é tranquila: trata-se de um PDF didático, seguro para análise, criado para mostrar como pequenos detalhes podem ser revelados antes mesmo de abrir o documento em um leitor.
Em um caso real, a postura continua a mesma: se algo não faz sentido, pare antes de clicar.